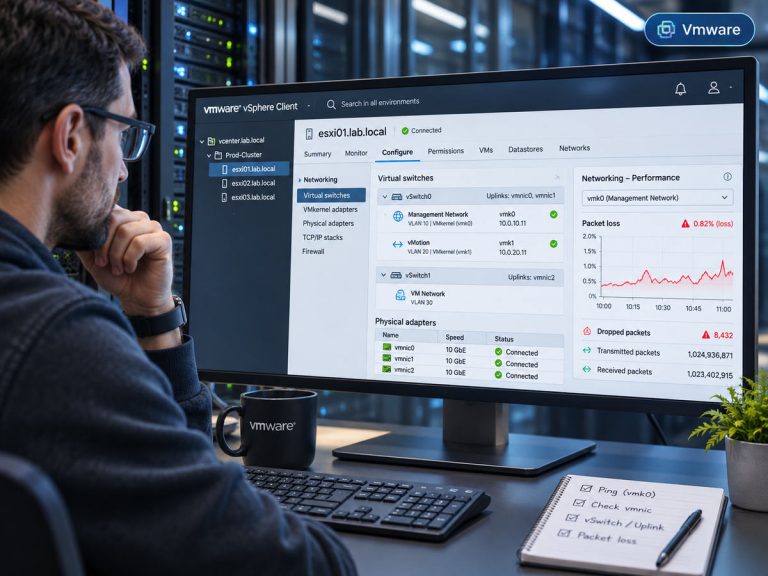
Bir gün izleme sisteminde ESXi host için “packet drop” alarmı görüyorsunuz. Aynı host üzerindeki bazı sanal makineler de zaman zaman bağlantı sorunu yaşıyor. İlk refleks genellikle fiziksel switch'i suçlamak oluyor. Oysa paket kaybı fiziksel kartta, sanal switch üzerinde, VM'nin kendi sanal adaptöründe veya yolun daha ilerideki bir noktasında ortaya çıkabiliyor. Önce nerede kaybolduğunu anlamak lazım.
Alarmdaki sayı neden tek başına yeterli değil?
Diyelim ki vmnic2 üzerinde 120.000 receive drop göründü. Bu rakam ilk bakışta yüksek. Fakat host haftalardır açıksa, sayaç uzun süredir biriken paketleri gösteriyor olabilir. Bir defalık büyük sayı yerine, sayaç artmaya devam ediyor mu? sorusunu sormak daha anlamlı.
Ayrıca kayıp miktarını toplam paket sayısından bağımsız okumamalıyız. Milyarlarca paket taşımış bir adaptörde az sayıda düşme ile dakikalar içinde hızla artan düşme aynı sorun değil.
İlk komut: fiziksel adaptörü kontrol edin
Host'a yetkili erişiminiz varsa aşağıdaki komutlar mevcut istatistikleri okur, ağ yapılandırmasını değiştirmez:
esxcli network nic list
esxcli network nic stats get -n vmnic2
Burada özellikle Packets received, Receive packets dropped, Packets sent, Transmit packets dropped ve CRC/error sayaçlarını not alın. vmnic2 yalnızca örnek; alarm hangi adaptördeyse onu kullanın.
Komutu bir dakika sonra yeniden çalıştırın. Örneğin receive drop değeri 120.000'den 120.000'e sabit kaldıysa geçmişte oluşmuş bir durumla karşı karşıya olabilirsiniz. 120.000'den 150.000'e yükseldiyse olay hâlen devam ediyordur. Bu değerler temsili; gerçek ortam ölçümü değildir.
Hangi VM'ler etkileniyor?
Fiziksel uplink birden fazla port group ve VM'nin trafiğini taşıyabilir. Bu nedenle etkilenen VM'lerin aynı port group, VLAN veya uplink üzerinden çıkıp çıkmadığını karşılaştırın.
esxtop aracıyla ağ ekranına geçilebilir:
esxtopArdından n tuşuyla ağ görünümüne geçin. Port ve sanal ağ istatistiklerini izlerken toplam sayaçlarla kısa zaman aralığındaki artışları karıştırmayın.
Burada ilginç bir ayrım var: Fiziksel vmnic sayaçları sabitken uygulama bağlantı kopması yaşıyorsa sorunu yalnızca NIC seviyesinde aramamak gerekir. Guest OS sürücüsü, vNIC tipi, firewall, yük dengeleyici veya karşı sistem de inceleme kapsamına girmeli.
Switch tarafını ne zaman incelemeli?
Kayıp sürekli artıyorsa aynı uplink'e bağlı switch portunun error, discard ve interface utilization değerlerine bakın. Farklı hız/duplex beklentileri, uyumsuz sürücü-firmware, anlık trafik patlamaları veya arabellek taşması gibi nedenler mümkün.
Jumbo frame kullanılıyorsa MTU değerinin uçtan uca tutarlı olduğundan emin olun. Ancak sırf alarm gördünüz diye bütün switch portlarında MTU değiştirmeyin; bu, mevcut bağlantıyı daha kötü hâle getirebilir.
Kendi kontrol sıram
Ben böyle bir alarmda önce üç şeyi aynı zaman çizelgesine koymayı tercih ederim: vmnic drop sayısının artışı, ilgili VM'lerdeki bağlantı sorununun saati ve fiziksel switch portunun sayaçları. Üçü aynı dakikalarda değişiyorsa aradaki bağlantı daha anlamlı hâle gelir.
Sorunun yalnızca bir VM'de mi yoksa host genelinde mi görüldüğünü belirlemek, saatlerce yanlış katmanda inceleme yapmayı önleyebilir. Üretim ortamında uplink veya driver değişikliği ancak etkisi ve geri dönüş planı bilindiğinde yapılmalı.
Kaynak notu: Broadcom Knowledge Base, “Checking and Monitoring Network Packet Drops on ESXi Hosts via CLI” (446789) ve ESXi network adapter istatistikleri belgeleri.